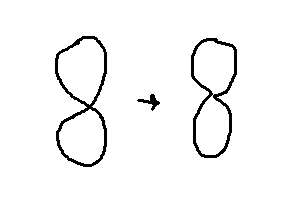Montag, 4. Juli 2022

Gendersprache? Unseriös! /s


Ein/e NutzerIn hat am 03. Juli 2022 20:34 einen Kommentar zur Frage 12 im Fall 'Notfall in der Restaurantküche' in der Fallsammlung 'Infektiologie II' abgeschickt:

Migranten sind gesünder als Einheimische Deutsche. So ein Unfug. Vielleicht wenn wir von Norwegern oder Dänen sprechen, aber ab südlich des Mittelmeerraumes ist das hier reines Wunschdenken. Die Gendersprache gibt hier noch zusätzlich den Hinweis, dass es sich bei den Autoren, um ein stark linkes spektrum handeln muss. Bitte mit einem seriösen Team austauschen. Danke


siehe https://de.wikipedia.org/wiki/Gesetze_und_amtliche_Regelungen_zur_geschlechtergerechten_Sprache & https://www.uni-wuerzburg.de/chancengleichheit/frauenbeauftragte/weitere-angebote/geschlechtergerechte-sprache/

Und wer sich weiter informieren will: Vortrag am 07.07.2022 18-19:30 https://www.uni-wuerzburg.de/chancengleichheit/frauenbeauftragte/aktuelles/single/news/gendergerechte-sprache/


Freitag, 7. Januar 2022

Wut im Bauch, Kaputte Kommunikation

 Folgender Kommentar trudelte über die "Weihnachtsferien" ein (am 04.01. ~19 Uhr):

dummste Erklärung ever! er schreibt nur die Lösung einfach wie ist das bitte jetzt eine Erklärung! der dozent soll lieber Wein verkaufen als Dozent bleiben kann nichts erklären wir kommen schon besser zu recht ohne seine Erklärungen!!!!


Die hinterlegte "dummste Erklärung ever!":


🤷‍♂️

Montag, 9. August 2021

Wut im Bauch (IV)

Die folgende Frage, die im Fall "Grundbegriff Bildung" im WueCampus-Kurs "Einführung in die Bildungswissenschaft" eingebaut ist, schaut doch eigentlich aus wie eine ganz normale Frage:

Donnerstag, 31. Dezember 2020

R.I.P. Flash

 Zu Beginn des CaseTrain-Projekts 2006/07 war Flash das beste Mittel um reichhaltige interaktive Inhalte im Web anzubieten und folgerichtig wurde der CaseTrain-Player auch in Flash (ActionScript 3) implementiert. Aber bereits wenige Jahre später wurde klar, dass früher oder später Flash nicht mehr die geeignete Technologie sein wird, um CaseTrain-Inhalte den Lernenden verfügbar zu machen:

2010 entschied Steve Jobs, dass es auf dem iPhone keine Flash-Unterstützung geben werde, und 2011 stellte Adobe die Entwicklung des Flash-Plugins für mobile Endgeräte ein.

Das war zunächst noch kein Problem für CaseTrain, da CaseTrain-Inhalte zum allergrößten Teil eher nicht für die (damals noch sehr) kleinen Displays von Smartphones geeignet waren und Tablets auch noch nicht allzu verbreitet waren  - insbesondere arbeiteten Studierende hauptsächlich mit einem anderen Gerät (Laptop/Desktop-PC) und nicht mit Tablets. Mit der Zeit wurden aber Stimmen lauter, dass doch insbesondere Tablets eine besonders komfortable Möglichkeit für das "Lernen zwischendurch" wären und zusätzlich meldeten sich immer mehr Studierende, die ausschließlich mit einem Tablet arbeiteten.

Relativ bald stand auch eine Web-Version des Players bereit, diese bot aber nur sehr eingeschränkte Funktionalität und konnte nur eingesetzt werden um Multiple-Choice-Fragesammlungen durchzupauken. Multimediale Inhalte, komplexere oder offene Fragetypen und die meisten Auswertungsschemata wurden nicht unterstützt.

Desweiteren wurde eine Variante des CaseTrain-Players, die zur Erfassung der Leistungen in praktischen Prüfungen in der Medizin zum Einsatz kam, durch eine HTML-Version ersetzt.

Aber erst 2013 konnte im Rahmen einer Masterarbeit der Prototyp eines (fast) full-featured HTML5-basierten Fallplayers entwickelt werden, der dann bis 2016 zum Produktiveinsatz gebracht werden konnte. Zu diesem Zeitpunkt wurde aber auch entschieden, dass bestimmte Funktionen des Flash-basierten Players nicht nachimplementiert würden (hauptsächlich aus konzeptuellen und didaktischen Gründen). Die Autor:innen wurden dann auch darauf vorbereitet, dass irgendwann alle Fälle nur noch über den HTML5-Player verfügbar sein werden.

Durch die Professur für Medizindidaktik und der damit verbundenen Anschaffung von 200 iPads für Prüfungen wurde die Entwicklung des HTML5-Players weiter angetrieben. Neue Funktionen machten die Prüfungen mit dem HTML5-Player immer attraktiver, so dass auch die Prüfungen im "bring your own device"-Szenario mit Laptops der Student:innen nicht mehr mit dem Flash-basierten Prüfungsplayer sondern mit dem HTML5-basierten durchgeführt wurden.

Obwohl die großen Browserhersteller (Chrome, Firefox, Internet Explorer / Edge, Safari) immer wieder darauf hinwiesen, dass es "bald" keinen Support für Flash-Inhalte mehr geben wird, hat erst Adobe mit der Ankündigung, alle Flash-Plugins Ende 2020 hart abzuschalten, im Sommer 2017 wirklich dafür gesorgt, dass die Browser nach und nach Flash-unfreundlicher wurden: Im ersten Schritt startete Chrome ab Herbst 2018 Flash-Inhalte erst, wenn die Nutzer:innen dem zustimmten und im zweiten Schritt Mitte wurde Flash in Chrome deaktiviert und musste erst von den Nutzer:innen aktiviert werden - Firefox folgte jeweils einige Wochen später. Zu Beginn des Wintersemester ging Chrome noch einen Schritt weiter und untersagte es Flash-Inhalten einer Webseite andere Flash-Inhalte der gleichen Webseite aufzurufen - damit wurde der Start von CaseTrain nicht mehr möglich, da der CaseTrain-Player von einem kleinen Vorab-Player gestartet wird. In Firefox war eine Bearbeitung der Fälle noch weiterhin möglich, allerdings war es schon in Firefox umständlicher Flash noch zu aktivieren.

Mit dem 31.12.2020 wird nun aber endgültig der Schlussstrich gezogen. Während Adobe durch Updates Mitte 2020 bereits dafür sorgte, dass das Flash-Plugin sich mit dem End-Of-Life selbst abschalten wird, haben die Browserhersteller nun auch mit den gerade aktuellen Versionen ähnliches Verhalten integriert. Es wird also ab dem 1.1.2021 schwer bis unmöglich sein, Flash-Inhalte zu starten.

Und dementsprechend wurde heute der Flash-basierte Fallplayer deaktiviert.


Die Entwicklung des Flash-basierten Fallplayers war mit jahrelanger Programmierarbeit, unzähligen internen Besprechungen und Brainstorming-Sitzungen mit gerade aktuellen und interessierten zukünftigen Autor:innen verbunden und wie praktisch jedes Modul im CaseTrain-Projekt wurde auch dieses letztendlich von einem einzelnen Entwickler erschaffen. Angesichts dieses riesigen Aufwands ist es schade, dass dieses Stück Software entsorgt wird. Andererseits steht eine für die aktuellen Anforderungen besser geeignete Ersatzlösung bereit. Und damit ist es eigentlich sogar gut, wenn man jetzt durch die Browserhersteller gezwungen wird, den alten Fallplayer endgültig abzulösen.


This is the way ;-)


Mittwoch, 24. Juni 2020

Wut im Bauch (III)

[Wut im Bauch continued …]

Ein/e NutzerIn hat am 23. Juni 2020 12:31 einen Kommentar zur Frage 26 im Fall 'Versuch BC0/BC2' in der Fallsammlung 'Mediziner-Praktikum' abgeschickt:

1,081 ist doch 1,1. Ich habe die Frage RICHTIG!!!!!!!!

Der Fragetext der Frage lautete: "Berechnen Sie die Konzentration der Serumprobe. Bitte geben Sie eine Nachkommastelle an." [Hervorhebung von mir]

"Oh, also wenn Sie 'richtig' in Großbuchstaben schreiben und dazu acht Ausrufezeichen verwenden, dann bekommen Sie den Punkt doch noch." *not*


Freitag, 20. September 2019

Enwicklungsprotokoll: Grafikmarkierungsfragen


Ein besonders spannender Typ von offenen Fragen sind Grafik-Fragen und dabei besonders die Variante, bei der auf einem Bild etwas markiert werden muss, da sich hier der Überdeckungsgrad der Markierung der Lernerin mit der von der Autorin festgelegten Region automatisch berechnen und das Ergebnis sich auch gut visuell erklären lässt.


Doch so ganz einfach ist das alles nicht ...

Eingabe


Das Zeichentool, das im CaseTrain-Player für das Markieren von Inhalten und für das Notizbuch verwendet wird (sketch.js) wurde für die Grafik-Markierungs-Fragen so erweitert, dass es immer eine geschlossene Fläche erzeugt, in dem der aktuell letzte Punkt des Streckenzugs (Polygon) immer mit dem Startpunkt verbunden wird.


Das erste Problem dabei ist schonmal, dass die Lernerin auch ein sich selbst überschneidendes Polygon zeichnen kann, in dem dann auch Lücken enthalten sein könnten.

Komplexe Polygone in einfache Polygone umwandeln


In einfacheren Fällen wären das Polygone mit einer Überschneidung wie eine 8, die man auch einfach so interpretieren könnte, als wären sie nicht selbst überschneidend.
Man kann aber auch leicht solche Polygone erzeugen:

Das macht zwar keinen Sinn, aber Lernerinnen (und Lerner) machen sowas ... und je nach Polygon-Färbungsregel entsteht dann ungefähr so eine Fläche:
Damit könnte man theoretisch einfach weiterarbeiten (immerhin kann man damit Lücken malen, vielleicht soll das so sein), aber das wäre nicht sinnvoll, da beim Zeichnen schwer vorhersehbar ist, wo die Lücken entstehen werden.


Eine Möglichkeit, solche Formen zu vereinfachen ist, die konkave Hülle zu berechnen - dafür gibt es eine Javascript-Bibliothek (concaveman @ github), der man einfach eine Menge der Punkte des Objekts übergibt und die dann die Punkte des Polygons für die konkave Hülle zurück liefert - aus Effizienzgründen muss man dabei das entstehende Polygon etwas vereinfachen, da sonst alle Punkte des Randes im Ergebnis-Polygon landen:


Eingabe
Ausgabe mit überlagerter Hülle (mit transparentem Gelb gefüllt)
Dieses Ersetzen der ursprünglichen Markierung durch die konkave Hülle darf aber nur geschehen, wenn sich das Polygon auch selbst schneidet. Falls die Lernerin absichtlich eine sich fast überschneidende Markierung eingibt, darf die Hüllung nicht angewendet werden, da diese wegen der Formvereinfachung die kleine Lücke schließen würde und der Ring durch ein komplett gefülltes Objekt ersetzt würde:
Man kann daher also nicht einfach die Hüllung immer verwenden, sondern nur wenn vorher festgestellt wurde, ob tatsächlich eine Selbstüberschneidung stattfindet oder nicht. Noch nicht gelöst ist dabei das Problem, wenn die Lernerin tatsächlich eine Donut-Form zeichnen will (ähnlich wie oben) aber absichtlich die Form (durch Überschneidung) schließt:

Ich habe noch keine Möglichkeit oder Heuristik gefunden, so eine absichtliche Selbstüberschneidung von einer versehentlichen, die es zu reparieren gilt, zu unterscheiden. Momentan wird daher jedes Polygon mit Selbstüberschneidung durch Hüllung repariert.

Um Selbstüberschneidungen zu finden vergleicht man "einfach" jedes Segment des Polygons mit jedem anderen und testet auf Überschneidung - dafür gibt es effiziente Algorithmen wie Bentley-Ottmann (Wikipedia), die auch schon in Javascript implementiert wurden (isect @ github). Ein Problem dieses Algorithmus' ist, dass sich zwei benachbarte Segmente immer in ihrem Verbindungspunkt "schneiden", weshalb das Polygon erst mit passenden Lücken versehen werden muss. Dies könnte naiv passieren, indem man einfach jeden Endpunkt eines Segments um -1/-1 verschiebt - was aber wiederum dazu führt, dass andere falsche Überschneidungen passieren (etwa wenn das Polygon danach einen Knick macht und damit den neuen Endpunkt schneidet obwohl es den ursprünglichen Punkt nicht geschnitten hätte). Lücken führen nur dann zu keinen Problemen, wenn die Segmentstrecken verkürzt werden ohne dass ihre Richtung geändert wird - dazu werden die (kartesischen) Koordinaten des Endpunkts von jedem Segment in Polarkoordinaten umgewandelt (Wikipedia), der Radius (und damit die Länge) wird um 1% verkleinert und die Koordinaten werden wieder ins kartesische System zurückübersetzt:
Da die Lücke damit immer zwischen zwei Pixeln liegt (kein Polygon hat Segmente die länger als 100 Pixel sind) können die Lücken nicht dazu führen, dass eine Überschneidung übersehen wird.

Praktischerweise bietet die verwendete Javascript-Bibliothek die Möglichkeit, die Überschneidungsberechnung beim Finden der ersten Überschneidung abzubrechen - da uns die Position der Überschneidungen bzw. überhaupt das Berechnen aller Überschneidungen nicht interessiert, ist die Berechnung damit wesentlich effizienter.

Mehrere Markierungen


Wie soll man damit umgehen, dass die Lernerinnen mit dem Zeichentool auch mehrere Markierungen setzen können? Verbieten ist schlecht, da das zum einen schwer zu kommunizieren ist - soll man das Zeichentool deaktivieren, wenn eine Markierung gesetzt ist und reaktivieren, wenn die Lernerinnen UNDO wählen? Soll man die erste Markierung kommentarlos durch die zweite ersetzen? Das wäre blöd, wenn sich die Lernerin bei der ersten Markierung viel Mühe gegeben hat und vielleicht mit der zweiten Markierung die erste nur ein bisschen verbessern wollte. Soll man jedesmal einen Hinweis einblenden, wenn der Markierungsbildschirm geöffnet wird oder soll irgendwo anders ein Hinweis hinterlegt sein, der durch Anklicken eines Icons geöffnet werden kann? Niemand liest Anleitungen ...

Aber da es den Autorinnen sowieso möglich sein soll, mehrere Regionen anzugeben, die zu markieren sind, sind diese Überlegungen eh müßig, denn dann müssen sowieso mehrere Markierungen möglich sein.


Bei mehreren Markierungen hat man dann wieder das Problem, dass man mit überlappenden Markierungen umgehen muss - es zu verbieten, dass sich Markierungen überlappen ist algorithmisch zwar möglich aber zu aufwändig (insbesondere auf unseren Prüfungs-iPads würde hier die Oberfläche unresponsiv werden). Mit überlappenden Markierungen einfach so weiterzuarbeiten ist aber auch nicht sinnvoll, da dann Regionen mehrfach überdeckt wären oder - für die Bewertung schlimmer - Pixel außerhalb von Regionen mehrfach überdeckt wären und zu doppeltem Abzug führen würden. Markierungen die sich überlappen müssen also vereinigt werden, schon allein deshalb weil die Lernerin eine gesetzte Markierung vielleicht erweitern will und dann mit zwei einander berührenden Markierungen weiterzuarbeiten, ist vielleicht auch nicht sinnvoll.


Mit den bisher eingesetzten Mitteln wäre das vielleicht einfach lösbar: Jede Markierung mit jeder anderen auf Überlappung testen (Markierung 1 malen, Pixel zählen, Markierung 2 transparent malen, Pixel zählen, bei Differenz überlappen sich die beiden), danach die Markierungen malen, alle Pixel bestimmen, konkave Hülle, fertig.


Jedoch, es wird komplizierter - denn Lernerinnen können z.B. mit mehreren Markierungen auch folgendes erzeugen:


links: erste Markierung, rechts: erste Markierung + weitere Markierung


Hier würde die konkave Hülle nach Eingabe der zweiten Markierungen den gesamten Innenraum mit ausfüllen und das wäre im Beispiel offensichtlich nicht beabsichtigt. Ab hier kann also nicht mehr mit komplett gefüllten Polygonen gearbeitet werden, sondern man muss mit Polygonen arbeiten, die beliebig viele Löcher (innenliegende Polygone) haben können. Mehrere Löcher könnten z.B. entstehen, wenn weitere überlappende Markierungen eingegeben werden:


Hier kann man sich natürlich die Frage stellen, ob man dafür wirklich einen Mechanismus vorsehen muss - aber wer weiß schon, welche Fragen sich die Autorinnen noch ausdenken werden? Und was die Lernerinnen dazu markieren werden? Zum Glück gibt es für das Vereinigen von Polygonen eine effiziente Javascript-Bibliothek, bei der es auch noch egal ist, ob das Polygon eine oder beliebig viele Löcher hat (Javascript Clipper @ SourceForge). Damit ist das Überlappen gelöst.


Und somit ist die Eingabe der Markierungen fast erledigt: Jede Markierung wird auf Selbstüberschneidung geprüft und ggf. durch die konkave Hülle ersetzt. Anschließend wird jede Markierung mit jeder anderen auf Überlappung getestet und sich überlappende Markierungen durch ein Polygon (mit ggf. Löchern) ersetzt, diese beliebig löchrigen Polygone werden wiederum miteinander verglichen usw. bis man am Ende separate Markierungen hat.


Ein kleines Problem ist hier nur die Geschwindigkeit:


Das Pixelzählen (zur Entdeckung der Überlappung) kostet Zeit und die Überprüfung auf Selbstüberschneidung kostet ebenso Zeit. Auf einem iPad ist das solange nicht spürbar, wie es nur wenige Markierungen gibt - aber wenn es viele kleine sich überschneidende Markierungen gibt, würde die Bedienung dann träge, wenn bei jeder neu hinzukommenden Markierung die entstehenden Polygone komplett neu berechnet werden. Daher werden zu jeder Markierung die daraus resultierenden Polygone gespeichert und bei einer neu hinzukommenden Markierung muss nur noch diese eine Markierung ggf. repariert werden und danach nur mit den gespeicherten Polygonen verglichen werden. Bei UNDO kann der vorherige Zustand sofort ohne Berechnung wiederhergestellt werden.


Eine weitere Optimierung, die angewendet wird, ist die Beschränkung beim Pixelzählen auf die relevanten Bereiche: Beim Pixelzählen zur Bestimmung der Überlappung zweier Polygone wird zuerst das umgebende Rechteck um jedes Polygon berechnet. Danach kann schnell berechnet werden, ob diese beiden Rechtecke überhaupt überlappen, und nur falls das möglich ist, werden die Polygone überhaupt gemalt. Und dann werden auch nur die Pixel gezählt, die sich im Rechteck befinden, das die beiden Rechtecke der gerade zu vergleichenden Polygone umgibt.
Ebenso wird beim Bilden der konkaven Hülle der Algorithmus nur auf das Rechteck angewendet, das das zu reparierende Polygon einschließt.


Technologie-Demo der Eingabe (Markierungen sind rot mit dünnem schwarzen Rand, Ergebnis-Polygone werden mit grünem Rand und transparent gelber Füllung darüber gemalt)


Auswertung


Bei einer idealen Bewertungsvorschrift gäbe es für jedes Pixel im Bild eine Wert, wie richtig oder falsch dieses Pixel ist, am Ende zählt man den Wert aller markierten Pixel zusammen und verrechnet das noch mit den nicht überdeckten Bereichen jeder Region.


Eine gute Vorschrift um den Korrektheitswert eines Pixel könnte sein, dass Pixel, die "nahe" an der Region sind, weniger falsch sind als Pixel, die weit entfernt sind - also etwa so:


Der grüne Kreis in der Mitte stellt eine einfache Region dar.


Wenn mehrere Regionen mit anderen Charakteristika existieren, dann wäre das Feld etwas komplizierter:


Im Prinzip könnte man jetzt einfach jedem Pixel die Bewertung geben, die sich aus obigem Bild ergibt, grün wäre richtig, rot wäre ganz falsch, die Farben dazwischen geben die jeweilige Falschheit an. Aber was passiert dann hier?


Sollte hier der Punkt A wirklich genauso falsch sein, wie die Punkt in der Ecke ganz oben rechts? Sollte er doppelt falsch sein, weil er außerhalb beider Regionen liegt? Oder sollte er weniger falsch sein, weil er insgesamt näher an beiden Regionen liegt? Und was ist mit Punkt B, falls die Lernerin die eingezeichnete Markierung gemacht hat? Sollte er wirklich als Überdeckung zur Region links oben und damit positiv zählen oder sollte er als rot gelten, da die Lernerin offensichtlich die Region rechts unten markieren wollte und den Bereich um B zu viel markiert hat? Hier stößt eine automatische Auswertung an ihre Grenzen - wobei sich vermutlich auch leicht Beispiele konstruieren ließen, bei denen sich eine menschliche Korrektorin auch schwer tun würde und die Lernerin fragen müsste, was sie gemeint hatte.


Zudem wurde zu den drei letzten Bildern noch gar nicht erwähnt, wie man überhaupt auf die Breite der Übergangsbereiche oder den genauen Verlauf des Falschheitswertes innerhalb des jeweiligen Übergangsbereichs kommt? Es ist ja vorstellbar, dass auf der einen Seite einer Region der Übergang relativ kurz und scharf sein müsste, aber auf der anderen Seite es auf etwas weniger oder mehr gar nicht wirklich ankommt. Die genauen Charakteristika müsste auf jeden Fall die Autorin eingeben - und da das mit vertretbaren Aufwand gar nicht praktisch möglich ist, kann die Bewertung hier leider auch nicht (falls das überhaupt technisch möglich wäre) optimal fair stattfinden.


Deshalb wird die Bewertung hier so vereinfacht, dass alle Punkte außerhalb der Region gleich falsch sind. Bei der Berechnung der Überdeckung einer Region mit einer Markierung ergeben sich somit 4 Arten von Pixel: Solche die in der Region und der Markierung liegen, solche die in der Region und außerhalb der Markierung liegen, solche die außerhalb der Region und innerhalb der Markierung liegen und solche die außerhalb der Region und außerhalb der Markierung liegen.


Um diese miteinander zu verrechnen, erhält jede Region die Werte m1 und m2:
* Wie viele Minuspunkte zählt ein nicht-markiertes Pixel der Region (Minuspixel Typ 1) (m1)
* Wie viele Minuspunkte zählt ein zuviel markiertes Pixel außerhalb der Region (Minuspixel Typ 2) (m2)
* Jedes Pixel innerhalb von Region und Markierung zählt +1 (Pluspixel)


Die Bewertung ist dann:


(Anzahl Pluspixel - m1 * (Anzahl Minuspixel Typ 1) - m2 * (Anzahl Minuspixel Typ 2)) / (Anzahl Pluspixel + Anzahl Minuspixel Typ 1)


Da es praktisch unmöglich ist, eine Region exakt zu markieren, gibt es zusätzlich noch einen Schwellwert, ab dessen Erreichen 100% gegeben werden. Zusätzlich erhält jede Region noch ein Gewicht für die Gesamtbewertung. Und damit ist der Überdeckungsgrad einer (oder mehrerer) Markierungen mit einer Region recht einfach zu berechnen.


Wie berechnet sich aber der Überdeckungsgrad, wenn eine Markierung mehrere Regionen überdeckt und diese Regionen ihre Minuspixel Typ 2 (wie sehr führen Pixel außerhalb der Region zum Abzug) unterschiedlich bestrafen. Wie viele Pixel werden als Minuspixel zu der einen Region gezählt und wie viele zur anderen?


Dies geschieht nach folgender Heuristik: Bedeckt die Markierung nur eine Region, dann werden alle Punkte innerhalb der Markierung und außerhalb der Region als Minuspunkte Typ 2 der Region gezählt. In obigem Beispiel würden dann die Punkte A und B zur unteren linken Region gezählt, da die Markierung die andere Region nicht berührt. Wenn eine Markierung mehrere Regionen berührt, dann wird die Fläche der Markierung die außerhalb der Regionen liegt anteilig den verschiedenen Regionen zugeordnet. Der Anteil richtet sich dabei danach, wie viele Pixel der jeweiligen Region von der Markierung überdeckt werden. Es lassen sich natürlich Sonderfälle konstruieren, die hier zu relativ sinnfreien Auswertungen führen.


Links würde unsere Heuristik zu einer sinnvollen Bewertung gelangen, die rote Fläche würde entlang der weißen Linie aufgeteilt. Bei der mittleren Markierung hingegen, würde - obwohl davon auszugehen ist, dass hauptsächlich die Region rechts unten markiert werden sollte - die Hälfte der roten Fläche der anderen Region zugeordnet werden. Ändert man die Heuristik und teilt nach Relation von überdeckter Fläche zu Gesamtfläche auf, dann würde im rechten Beispiel ein viel zu großer Anteil der roten Fläche (nämlich die Hälfte, da beide Regionen komplett überdeckt sind) der kleinen Markierung rechts unten zugerechnet werden. Man könnte versuchen, die beiden Heuristiken gewichtet miteinander zu kombinieren, aber wie soll man das dann beim Feedback der Lernerin transparent machen?


Komplexere Aufteilungsalgorithmen, z.B. unter Berücksichtigung des Abstands zur nächsten Region, der Schwerpunkte der Regionen usw. verbieten sich leider, da die Berechnung hierbei zu komplex wären um noch in annehmbarer Zeit durchgeführt werden zu können und für das Beispiel oben links das vermutlich sinnvollste Ergebnis zu erreichen:
Selbst im Fall der einfacheren Heuristik muss darauf verzichtet werden, für jedes Pixel individuell zu ermitteln welcher Region es zugeordnet wird - etwa um anzeigen zu können, welche Minuspixel Typ 1 zu einer bestimmten Region gezählt werden. Das Berechnen der Anzahl der Pixel die jeweils den von der Markierung getroffenen Regionen zugeordnet werden muss reichen. Sonst müsste man dazu bei nur zwei betroffenen Regionen eine Trennlinie finden, die irgendwie sinnvoll zwischen den Regionen liegt. Die Richtung dieser Trennlinie zu berechnen ist aufwändig, und diese dann noch soweit hin und herzuschieben, dass sie die Fläche in genau dem richtigen Verhältnis teilt ist nicht-trivialer zusätzlicher Aufwand. Sind mehrere Regionen betroffen, dann müsste eine Zerlegung der Markierung ähnlich zu Voronoi-Diagrammen berechnet werden - nur mit den Regionen statt Punkten als Zentren.


Bleibt noch die Frage, wie man mit Markierungen umgeht, die keine Region überdecken. Eigentlich müssten auch diese der bzw. in verschiedenen Anteilen den nähesten Region/en zugeordnet werden - da dies wegen des hohen Berechnungsaufwand aber ebenso wenig möglich ist, wie die Aufteilung einer Markierung die mehrere Regionen überdecken, wird diese Region einfach auf alle Regionen gemäß deren Größen aufgeteilt.


Video zur Auswertung (Regionen sind weiß, Markierungen gelb, beim Antippen einer Region werden die Pluspixel grün angezeigt, alle Minuspixel vom Typ 1 bzgl. der angetippten Region werden rot angezeigt, in das Ergebnis oben links fließen aber nur die tatsächlich dieser Region zugeordneten Minuspixel Typ 1. Die Minuspixel Typ 2 werden blau angezeigt. In der Demo sind keine Markierungen vorhanden, die keine Region überdecken.


Feedback


Das Feedback besteht aus zwei Komponenten: Einmal einem Text-Generator, der zur gewählten Region den zugehörigen Text erzeugt und zum anderen eine (schöne) Oberfläche. Eine spannende Frage ist, wo in der Oberfläche der Text angezeigt wird - das ist ja nicht trivial, da der Text den relevanten Teil der Oberfläche nicht verdecken darf. Da der Text-Generator relativ einfach umzusetzen ist (abgesehen von der nervigen Internationalisierung) soll hier nicht weiter darauf eingegangen werden - erwähnenswert ist hier dass bei der Generierung unterschieden wird zwischen Markierungsfragen bei denen nur eine Region zu markieren ist und solchen mit mehreren Regionen. Zudem erscheint bei nur einer Region die Erklärung sofort, bei mehreren Regionen erscheint ein Hinweis, dass man eine Region anwählen muss um die zugehörige Erklärung zu sehen.


Bei der Platzierung des Feedbacks wurde so vorgegangen, dass es 7 Stellen gibt, an denen der Kasten erscheinen kann: Oben/Mitte, Mitte/Links, Mitte/Mitte, Mitte/Rechts, Unten/Links, Unten/Mitte und Unten/Rechts. Oben/Links ist ggf. das Vergrößerungsfenster, Oben/Rechts ist der Schließen-Button.


Bei Öffnen des Fensters (bei mehreren Regionen) und Änderungen der Oberfläche (bei Verschieben wenn nur ein Ausschnitt des Bildes zu sehen ist) wird das die relevanten Objekte umschließende Rechteck berechnet und dann berechnet auf welcher Position das Feedback die wenigste Überschneidung hat.


Ein Problem das dabei auftritt ist, dass zur Berechnung der Überschneidung zwischen Feedback-Fenster und relevantem Rechteck nicht das Feedback-Fenster bewegt werden kann, das würde man als Flackern wahrnehmen. Stattdessen wird: In die Feedback-Box der richtige Text eingesetzt (so dass die Feedback-Box die richtige Größe hat), ein unsichtbares Element mit der genau gleichen Größe erzeugt, dieses an alle möglichen Positionen gesetzt und die Überschneidung berechnet, die optimale Position ausgewählt, das unsichtbare Element wieder entfernt und abschließend die Feedback-Box ggf. umpositioniert. Die optimale Position ist dabei die, bei der die Überschneidung am minimal ist und falls mehrere Positionen hier gleich sind, dann wird die bevorzugt, bei der das umgebende Rechteck um das relevante Rechteck der Markierungen und Regionen und um das Feedback-Fenster minimal ist.


Zunächst wurde versucht, die Positionierung über eine CSS-Klasse des umgebenden HTML-Elements zu realisieren, doch leider war dies zu langsam: Wurde direkt danach die Überschneidung ausgerechnet, dann war die Box noch nicht umgesetzt und der alte Wert als neuer Wert berechnet. Man hätte hier mit MutationObservern usw. arbeiten müssen, was zu aufwändig war. Danach wurde die Position über eine CSS-Klasse des Elements selbst verändert und dies funktioniert.


Video zum Feedback


Um unnötiges Springen (wie im Video zu sehen) zu verhindern wird zusätzlich bei Verschieben des Ausschnitts gemerkt, an welcher Position das Feedback zuletzt platziert war und nur wenn das umgebende Rechteck das Feedback berührt wird die Position geändert.


[TBD: Upload, Failures]

Änderungen

Nach ersten Tests ist aufgefallen, dass die zuwenig markierte Fläche hier doppelt als falsch gezählt wird: Einmal weil nur die überdeckte Fläche als Plus-Prozentpunkte gewertet wird und danach wird nochmal die fehlende Fläche als Minus-Prozentpunkte abgezogen. Aus diesem Grund wurde das Einlesen und der Player so verändert, dass bei fehlendem Wert der Default-Wert 0 gesetzt wird, der bedeutet dass die fehlende Fläche nicht mehr doppelt abgezogen wird.


Momentanes Endprodukt


Kompletter Fall mit Grafik-Eingabe-Fragen und Grafik-Markierungs-Fragen


Dienstag, 12. Februar 2019

Doodle

Manchmal geht man in eine Prüfung und hat sich nicht so richtig gut vorbereitet und dann kommt vielleicht auch noch ausgerechnet das dran, was man am wenigsten kann ... und dann ist man relativ früh mit allen Fragen durch und ist am Prüfungsende angekommen ... und wenn man dann noch die Prüfung nicht vorzeitig verlassen darf und zusätzlich Papier für Notizen am Platz hat ... dann sitzt man so da und hat ein noch ziemlich leeres Papier und noch ziemlich viel Zeit vor sich ... und dann entsteht manchmal sowas:


(c) Prüfling im WS18/19


Montag, 21. Januar 2019

Into the Box (II)

Die verbesserten Halterungen sind fertig, außerdem wurden für jeden Kasten eine kleine Mehrfachsteckdose und zwei Ladegeräte á 10 Ports angeschafft:


Die Halterungen sind hier nicht geklebt - die rechte Seite hält alleine durch die genaue Verzahnung und das Einpassen in die Aussparungen des Kastens. Die Kabelführung erfolgt hochprofessionell mit Klettbändern und testweise einem Tüten-Clip (bei dem der eine Steg entfernt wurde) - für die bessere Aufspreizung der Ladekabel ist ein gedruckter Halter angedacht.


Wir überlegen noch, ob wir für das Laden kürzere Lightning-Kabel mit Winkelstecker anschaffen sollen, bisher haben wir aber noch keine solchen Kabel in der richtigen Länge für einen erschwinglichen Preis gefunden: 20cm für 1,50€/Kabel sind zu kurz, 30cm für 9€/Kabel sind zu teuer ...


Zusätzlich wurde für jeden Kasten noch ein kleiner Karteikasten mit entsprechend der iPads nummerierten Fächern angeschafft. Dieser wird jedem Kasten beigelegt und vereinfacht die Ausgabe der einzelnen iPads gegen Pfand (z.B. in Prüfungen) vor Ort.


Die iPads können nun dank Upgrade unseres jamf pro Servers auch unter iOS 12.1.1 gemanagt werden - allerdings läuft das Management (noch?) nicht so wahnsinnig rund: Kommandos an die Geräte dauern mitunter Stunden, iOS Updates blieben hängen, Geräte melden nur sehr verzögert ihr Inventory, usw. Ob das daran liegt, dass 60 Geräte, die einem Schrank aufeinanderliegen einfach physikalisch Schwierigkeiten mit dem WLAN haben, oder daran, dass die zugrundeliegende Technologie (Push via Apple - aber wann wachen die Geräte überhaupt mal auf und bauen dann auch eine aufwändigere WLAN-Verbindung zum eduroam auf) jede Kommunikation mit Geräten verzögert, ist noch unklar. Diese Verzögerung schränken das Ganze aber nur insoweit ein, dass Geräte eben nicht "von jetzt auf gleich" administriert werden können sondern nur "von heute auf morgen".

Donnerstag, 13. Dezember 2018

Into the Box

... oder "Wir bauen uns eine iPad-Aufbewahrung"


Nachdem die Humanmedizin 180 und die Zahnmedizin 60 iPads angeschafft haben, um damit elektronische Prüfungen durchzuführen und uns immer mehr Anfragen von Lehrenden erreichen, die elektronisches Prüfen auch mal ausprobieren wollen, aber keine eigenen Geräte haben, konnten auch im Rechenzentrum 60 iPads beschafft werden. Bei der Aufbewahrung wollten wir aber nicht den Weg der Medizin gehen und Transportwägen anschaffen, wo jeder Wagen soviel kostet, wie die enthaltenen Geräte zusammen (ja, SO teuer sind die).


Da wir die Geräte in kleineren Mengen (20 Stück) verleihen können wollen, kommt eine große Aufbewahrung nicht in Frage. Da 20 iPads ganz schön schwer sind, sollten die Transportkisten möglichst leicht sein und wir haben uns letztlich für diese entschieden:


Zum Glück haben wir im Haus ein 3D-Druck-Team und nach einigem Ausprobieren hatten wir eine erste Version des Insets:


Eigentlich müssen da noch ein paar Teile verschraubt werden und andere Teile in die Kiste geklebt werden, aber alles hält momentan durch die top passgenaue Fertigung auch einfach so und sieht dann so aus:


Die leichte Wölbung ergibt sich auch daraus, dass kein Drucker mit beheizter Platte verwendet wurde. Mit ein paar iPads, den Original-Lightning-Kabeln und einem 6-fach Amazon Basics Ladegerät hat man dann schon sowas:


Und mit allen 20 (ok es sind nur 19, da mit dem Gerät #1 gerade getestet wurde) dann so:
 

Die Verkabelung ist natürlich noch ganz furchtbar, mal sehen ob wir ein 20er USB-Ladegerät finden oder noch was reindrucken, um die existierenden Ladegeräte darin schöner verstauen zu können. Dann noch kurze Winkelstecker, um die iPads anzustöpseln, dann sollte das soweit tun. Die Wärmeentwicklung hält sich im Rahmen - solange die Kiste offensteht :)


Für die Kästen Nr. 2 und Nr. 3 werden die Insets nochmal überarbeitet - sobald diese fertig sind, werden wir die 3D-Modelle hier open sourcen.


Mittwoch, 5. Dezember 2018

Fragepools - bau dir deine eigene Lerneinheit

tl;dr CaseTrain unterstützt nun Fragesammlungen als "first class feature". Studierende können sich aus Fragesammlungen durch verschiedene Filter selbst Lerneinheiten zusammenstellen, den eigenen Lernfortschritt verfolgen und miteinander über Fragen diskutieren.


A long time ago ... wurde CaseTrain für die Unterstützung von Problem-Orientiertem Lernen konzipiert: Die Lehrenden sollen realistische Problemfälle erstellen können, die alle Informationen enthalten (oder auf diese verweisen), die für die Lösung des Problems notwendig sind und die angereichert sind mit aufeinander aufbauenden Fragen, bei denen fehlerhafte Entscheidungen erklärend korrigiert werden. Damit soll den Lernenden zum einen das notwendige Wissen vermittelt werden, zum anderen aber auch die relevanten Lösungsstrategien und deren Anwendung.

Es gibt aber auch Fächer, bei denen zur Prüfungsvorbereitung traditionell sehr viele Fragen verfügbar gemacht werden, die voneinander völlig unabhängig sind und sich daher kein oder kaum didaktischer Mehrwert erzielen lässt, wenn man diese Fragen künstlich in verschiedene "Fälle" verpackt. Im Gegenteil wäre es für die Lernenden sogar hilfreicher, wenn sie sich aus diesen Fragen selbst Lerneinheiten zusammenstellen könnten, um so bestimmte Themen gezielt vertiefen oder das gesamte Wissen vor der Prüfung in selbst gewählten Blöcken wiederholen zu können.

Das CaseTrain Feature "Fragepools" wurde entwickelt, um auch diese Art des Lernens besser unterstützen zu können.

Dozierende können eigene Fragepools befüllen, indem sie die in ihren bereits existierenden Fällen enthaltenen Fragen extrahieren lassen oder ihre Fallsammlungen wie Fälle ins System einstellen - ohne dass diese "Fälle" selbst den Studierenden zugänglich gemacht werden. Der wirkliche Mehrwert für die Studierenden ergibt sich aber erst, wenn die Fragen nach einer selbst wählbaren (ggf. hierarchischen) Klassifizierung verschlagwortet wurden, da sich daraus erst die Filtermöglichkeiten für die Lernenden ergeben.

Studierende können auf die Fragepools - wie bei den CaseTrain Fällen auch - über Links in ihrem wuecampus-Kurs zugreifen. Dadurch, dass hier die Anmeldeinformationen weitergereicht werden, wird auch bei der Nutzung der Fragepools der individuelle Lernerfolg bzw. -fortschritt erfasst, so dass die Studierenden beim Zusammenstellen von weiteren Lerneinheiten - über die Filtermöglichkeiten durch die Verschlagwortung hinaus - gezielt die Suche weiter auf solche Fragen einschränken können, die sie z.B. schon mehrfach falsch oder in den letzten 2 Wochen noch nicht bearbeitet haben - oder natürlich Kombinationen davon: "Gib mir alle Bild-Fragen aus Prüfungen von Wintersemester 17/18 oder Sommersemester 18 zum Organ Lunge, die ich zuletzt falsch beantwortet
habe."


Die Fragen in solchen Prüfungsfragen-Sammlungen unterscheiden sich von Fragen, die in Problem-Fällen eingebaut wurden, zusätzlich meist dadurch, dass keine Erklärungen hinterlegt sind - da sich die richtigen Antworten direkt aus dem Vorlesungsinhalt ergeben, während bei Problem-Fällen der Kontext der Frage relevant ist.

Für Studierende aber ist eine ausführliche Erklärung das Wichtigste, sogar wichtiger als eine individuelle Auswertung - die man durch Vergleich der eigenen Antwort mit der richtigen Antwort auch dann erfassen kann, wenn das Ergebnis nicht auf einen halben Punkt genau präsentiert wird.

Deshalb wurde für Fragepools die Anbindung an ein (wuecampus-) Frage-Forum ermöglicht.

Jedesmal wenn zu einer Frage das Feedback präsentiert wird (egal ob eine Erklärung hinterlegt ist oder nicht) erscheint nun auch ein Link direkt zur Diskussion der jeweiligen Frage im Frage-Forum. Sobald zum ersten Mal eine Studentin oder ein Student diesen Link anklickt, wird mit einem Start-Beitrag, der u.a. den Fragetext und Antworten enthält, die Diskussion zu dieser Frage eröffnet, bei der alle Studierenden mit eigenen Beiträgen teilnehmen können.

Es steht bei den Frage-Forums den Dozierenden frei, inwieweit sie hier selbst aktiv werden wollen, ob sie also selbst zu den Diskussionen beitragen wollen und ob sie Fragen, bei denen nachweislich Diskussionsbedarf besteht, nach und nach mit "offiziellen" Erklärungen versehen.


↗ Ausführliche & bebilderte Beschreibung auf der CaseTrain-Website


Für das Feature Fragepools sind sicher noch viele interessante Erweiterung möglich. Wenn Sie eine Idee haben, dann schreiben Sie einfach an casetrain@uni-wuerzburg.de

Montag, 19. November 2018

Wut im Bauch (II)

[Wut im Bauch continued ...]

Man kann seine Unzufriedenheit so formulieren:

Ein/e NutzerIn hat am 15. November 2018 11:30 einen Kommentar zur Frage 13 im Fall 'Helfen bis zum Schluss' abgeschickt:


Dumme Frage. Religionsunterricht gehört nicht ins Medizinstudium. Frau/Patient soll einfach formulieren "wie das bei ihnen daheim üblich ist". Patientenwunsch ist zu beachten, aber so als Frage absoluter Quatsch!

oder so:

Ein/e NutzerIn hat am 15. November 2018 11:30 einen Kommentar zur Frage 14 im Fall 'Helfen bis zum Schluss' abgeschickt:


ICH BIN KEIN MOSLEM UND DAS KEIN SCHEIß RELIGIONSUNTERRICHT!!!!!!! Ich achte sehr gerne die Wünsche der Angehörigen aber wenn ich jetzt von jeder Religion die Totenbestattung auswendig lernen soll geht das zu weit! Vor allem wenn man so etwas in der Prüunf fragt. Ich habe auch keine Ahnung wie das Zeugen Jehowas, Christen, Juden, Buddhisten oder sonst wer perfekt nach ihren Vorschriften macht!


Liebe Studierende ...
https://www.teepublic.com/t-shirt/1533982-chill-bro-you-need-to-let-that-shit-go
T-Shirt Design von TEEPUBLIC / rkitty16

Donnerstag, 8. November 2018

2FA


Nachdem kürzlich bei einer Rechenzentrum-internen Schulung eine Softwarelösung zur Verwaltung von automatisch rotierenden Passwörtern vorgestellt wurde, ist aufgefallen, dass ein kleines Modul dieses komplexen Produkts bequem und kostenlos zur Generierung und Validierung von nur kurze Zeit gültigen Einmal-Passwörtern (time-based one-time-Passwords / TOTP) verwendet werden kann.


Dieses Modul ließ sich dann relativ einfach in CaseTrain einbauen und damit haben Autorinnen nun die Möglichkeit, den eigenen Account beim CaseTrain/manager - und damit auch beim CaseTrain Prüfungssystem - mit einem zusätzlichen zweiten Geheimnis (2-Faktor-Authorisierung / 2FA) weitaus stärker abzusichern.


Dazu benötigt man eine App (Suche: "2FA App"), die solche Einmal-Passwörter generieren kann, muss damit 2FA im CaseTrain/manager aktivieren (indem man einen QRCode zur Einrichtung mit der App scannt) und ab dann muss zusätzlich zum normalen Passwort das aktuell gültige Einmal-Passwort aus der App eingegeben werden.


Wer den Zugang zum eigenen Account absichern möchte ⇒ Anleitung

CaseTrain empfiehlt Authy für iOS, Android, Chrome, macOS und Windows

Dienstag, 10. Juli 2018

Aww

Ein Nutzer hat am 09. Juli 2018 12:12 einen Kommentar zur Frage 3 im Fall 'Klausur QMB SS 13 Teil 1' abgeschickt:
Ich danke Ihnen für diese Fragen <3
Link zum Fallkommentar:...

Donnerstag, 22. März 2018

Testate für alle!


Bisher konnten sich Lernende nur bei personalisierten Bearbeitungen (z.B. über wuecampus) eine Bescheinigung über eine erfolgreiche Fallbearbeitung (oder über alle erfolgreichen Bearbeitungen eines Kurses) erstellen lassen.


Es gibt aber auch Szenarien, bei denen die Bearbeitungen ohne vorherige Anmeldung an einer Lernplattform stattfinden und sich die Lernenden trotz anonymer Bearbeitung im Anschluss ein personalisiertes Testat erstellen lassen können.


Testate über erfolgreiche anonyme Bearbeitungen


Dazu gibt es nun eine Erweiterung die durch Hinzufügen einer HTML-Datei bei der Fallerstellung genutzt werden kann. Im Abschlusskommentar des Falles erscheint ein Link, der eine neue Seite öffnet, auf der man seinen Namen eingeben kann und sich ein Testat erstellen lassen kann. Die Validität dieses Zertifikats kann mittels eines aufgedruckten QRCode nachher jederzeit überprüft werden.


Mehr dazu in der Dokumentation


Dienstag, 6. März 2018

Komische Lyrik (I)

Um keine Meldung zu technischen Problemen zu verpassen werden alle Kommentare zu Fragen auch an die Admin-Accounts weitergeleitet. Da flattert auch mal Merkwürdiges in das Postfach, wie heute z.B. folgendes:


Ein Nutzer hat am 05. März 2018 11:39 einen Kommentar zur Frage 13 im Fall 'CaseTrain: Sozialisation' abgeschickt:
I would like to get pregnatn as an 18-year old wife Mr. Presiden, but I habe got overweight since many years and I am already 49.
Link zum Fallkommentar: ...


Mittwoch, 26. April 2017

Videos, Sequenzen, Textfragen und mehr

Videos


Mit dem Flash-Player ist die Welt hier einfach: Mit ffmpeg jedes Video nach flv konvertieren und fertig. Da die Konvertierung normalerweise auch ziemlich schnell geht ist diese einfach in den Vorgang des Falleinlesens integriert. Sobald also der Fall eingelesen ist und gestartet werden kann, sind auch die Videos konvertiert und abspielbar - in Flash und auf jedem Browser.

Mit dem HTML5-Player, der direkt im Browser läuft, sind Videos furchtbar kompliziert geworden: Zum einen gibt es verschiedene Formate, die die jeweiligen Browser (auch abhängig vom Betriebssystem) unterstützen - Safari @ iOS mag gar nichts außer MP4, gestreamt bitte als HLS, Chrome unterstützt mehr Formate, mag aber als Streaming-Methode eher DASH, alte Browser haben keine passende GPU für ein effektives Dekodieren von H.264 und Firefox ist besonders empfindlich, was verschlüsseltes Streaming betrifft. Zum anderen haben die Geräte der NutzerInnen auch noch verschiedene Bildschirmgrößen bzw. -auflösungen und Internet-Bandbreiten, so dass EINE Datei nicht mehr alleinseligmachend sein kann.

Zum Glück betreibt das Rechenzentrum einen Video Streaming Server, der diese Probleme löst: Man schickt ihm ein Video und dieses wird in verschiedenen Formaten (H.264 als DASH / HLS / Native) und Größen bereitgestellt, so dass jeder Client das Video in der ihm passenden Art erhalten kann.

Das Zusammenspiel der beiden Systeme ist nicht ganz einfach: Die Videos müssen beim Hochladen dem Videoserver übermittelt werden, so dass die AutorInnen damit keinen zusätzlichen Aufwand haben, einmal so auf dem Videoserver verfügbar gemachte Videos sollen in anderen Fällen wiederverwendet werden können, und der Player muss vom Server ein Video anfordern, das beim Erzeugen des Falles noch gar nicht existiert.

Und so geht's: Um den Videoserver zu entlasten, werden alle Videos - zusätzlich zur Konvertierung ins flv-Format - auf dem CaseTrain-Server auch noch mit dem x264 Encoder vorkonvertiert, erhalten einen eindeutigen Namen und werden an den Videoserver übertragen, d.h. in einen CaseTrain-Ordner auf den Videoserver kopiert.
Regelmäßig überprüft der Videoserver den Ordner auf neue Dateien, erkennt dabei neue Videos, registriert diese in seiner Datenbank (und gibt ihnen dabei eine eigenen eindeutigen Namen), steckt sie in die Verarbeitungspipeline und eine ungewisse Zeit später sind sie dann fertig konvertiert (neben verschiedenen Größen werden auch für das Streaming optimierte key frames eingefügt).

Der CaseTrain-Server wiederum überprüft regelmäßig den Zustand "seiner" Videos auf dem Videoserver und kann erkennen, ob das Video registriert ist und ob die Konvertiertung beendet wurde. Sobald erkannt wurde, dass das Video fertig ist, schickt der CaseTrain-Server der Autorin des Falles eine entsprechende Mail - ab diesem Zeitpunkt kann der Fall im HTML5-Player abgespielt werden und das Video auch in anderen Fällen verwendet werden. Bereits ab der Registrierung in der Datenbank kann die Autorin schon nachschauen, unter welcher Adresse das Video in weiteren Fällen verwendet werden kann.

Im Fall selbst (der nach dem Hochladen nicht mehr verändert wird), steht für jedes Video nur der Identifikator, den CaseTrain bei der Fallerzeugung vergeben hat, zum Abspielen benötigt der Player aber den Identifikator des Videoservers. Daher fragt der CaseTrain-Player beim Fallstart den CaseTrain-Server nach dem bzw. den jeweiligen Videoserver-Identifikator/en, die dieser in der Videoserver-Datenbank nachschaut und zurückmeldet. Der CaseTrain-Player erzeugt daraus verschiedene Quellen für das Video.
Für das Abspielen wird der von Universität Würzburg lizensierte Flowplayer verwendet, der dann den Magie-Teil übernimmt und das Video auf die für die jeweilige Umgebung passende Weise abspielt ggf. auch als SSL verschlüsselten Stream.

Mehr in der Dokumentation und noch mehr in der Dokumentation.

Sequenzen


CaseTrain kennt 2 Bearbeitungsmodi: Den linearen Modus und den freien Modus. Im linearen Modus muss jede Frage beantwortet werden, bevor man zur nächsten Frage weitergehen kann. Eine Navigation zurück ist nicht möglich - frühere Infos, Fragen, Antworten und ggf. Auflösungen und Erklärungen sind über die Übersicht zugänglich. Im freien Modus kann man beliebig zwischen Fragen springen und Fragen mehrfach beantworten. Normalerweise finden alle Bearbeitungen, bis eine Bearbeitung komplett abgeschlossen wurde (egal mit welchem Ergebnis), im linearen Modus statt. Bei allen weiteren Bearbeitungen können die Studierenden über die Übersicht beliebig zu Fragen und Abschnitten springen, vor- und zurückblättern und Fragen neu beantworten. Dieses Verhalten kann von den Autorinnen beeinflusst werden, so kann die freie Navigation und das Fragen neu beantworten unabhängig voneinander immer erlaubt oder immer verboten werden. Immer erlauben macht Sinn bei Fragesammlungen, immer verbieten macht Sinn bei konstruktiven Fällen, bei denen die Fragen aufeinander aufbauen.

Bei Fällen, die sowohl aus Abschnitten mit voneinander unabhängigen Fragen bestehen als auch Abschnitte bzw. Fragen beinhalten, die aufeinander aufbauen und daher nur in der vorgegebenen Reihenfolge beantwortet werden können, gibt es nun die Möglichkeit, solche Abschnitte als Sequenzen auszuzeichnen. Es kann dann ggf. immer noch frei navigiert werden, alle späteren Inhalte einer Sequenz bleiben aber verborgen bis alle Fragen vorher beantwortet wurden. Zudem kann jede Frage innerhalb einer Sequenz nur einmal beantwortet werden. Sequenzen können auch in Prüfungen verwendet werden.

Mehr dazu in der Dokumentation.

Textfragen


Textfragen können nicht automatisiert ausgewertet werden. Die Lernenden haben nur die Möglichkeit sich selbst zu bewerten, was mit den Erklärungen der Fallautorin unterstützt werden kann. Eine bessere bzw. weitere Möglichkeit ist das Hinzufügen von Bewertungskritierien, anhand derer eine objektivere Bewertung durch die Lernenden selbst vorgenommen werden kann. Es war schon lange möglich, diese Bewertungskriterien einzugeben - jetzt gibt es auch im HTML5-Player die Möglichkeit, diese einzusetzen.

Mehr dazu in der Dokumentation.

Die Lernenden sehen am Ende das Gesamtergebnis aufgrund ihrer eigenen Bewertungen - nichtsdestotrotz bleibt die Eigenbewertung nur eine zusätzliche Bewertung, "offiziell" zählt nur eine Bewertung durch Korrektorinnen und da diese beim freien Training nicht stattfindet wird, wird dort (vorerst...) weiterhin jede Textfrage mit 0% gewertet.

Evaluationsfragen im Fall


Es ist möglich am Ende des Falles eine Evaluation durchzuführen, diese Fragen müssen - auch im linearen Modus - nicht beantwortet werden, werden nicht ausgewertet und fließen daher auch nicht in die Bewertung ein.

Es gibt aber verschiedene Situationen, in denen es auch Sinn macht, Evaluationsfragen innerhalb des Falles zu stellen, z.B. könnte man nach Meinungen der Studierenden fragen oder Fragen zur Selbsteinschätzung zu Beginn des Falles stellen usw. Im Flash-Player gab es die Möglichkeit, Fragen als Quasi-Evaluationsfragen behandeln zu lassen, indem man sie mit 0 Punkten gewichtete und keine richtige Antwort hinterlegte. Dies unterstützt nun auch der HTML5-Player. Zusätzlich werden diese Fragen in der Übersicht anders angezeigt und tauchen in der Endbewertung gar nicht mehr auf.

Vereinfachungen bei konstruktiven Fällen


Es gibt einige Fälle bei denen nach und nach eine Lösung aufgebaut wird, dabei ändern sich die Titel der Abschnitte nicht und den Infos die links angezeigt werden werden nur immer weitere hinzugefügt. Für die AutorInnen ist das ein bisschen umständlich, da immer der Abschnittstext kopiert und dann ergänzt werden muss. Muss dann ein Inhalt des ersten Abschnitts verbessert werden, dann muss der gleiche Inhalt ebenso in allen folgenden Abschnitten nach-verbessert werden. Deshalb gibt es nun die Möglichkeit, dies effizienter einzugeben:

Wird als Abschnittstitel nur ein * eingegeben, dann wird der vorherige Abschnitt soweit übernommen und um die Inhalte des Abschnitts ergänzt. Dies kann mehrfach hintereinander gemacht werden, so dass nur im ersten Abschnitt ein Titel und die Startinformationen angegeben werden und in weiteren Abschnitten dann immer nur * und die neu hinzukommenden Inhalte.

Mittwoch, 22. März 2017

Multi-Choice-Fragen

Ein weiteres Feature, das dem HTML5-Player noch fehlte, sind die Mehrfach-Auswahl-Fragen, bei denen mehrere Teilfragen auf die gleiche Weise beantwortet werden müssen.


Nach einigem Refaktorieren konnte dieses Feature so implementiert werden, dass die vorhandenen Mechanismen zur Beantwortung von Auswahlfragen, zum Erzeugen der Erklärungen und zum Verrechnen bei Mehrfachfragen (wie bei Mehrfach-Wort- oder -Zahlen-Fragen) zur Bewältigung von Mehrfach-Auswahl-Fragen wiederverwendet werden konnten


Ein Vorteil gegenüber der Implementierung im Flash-Player ist, dass damit prinzipiell auch andere Auswertungsschemata bei Multi-MC-Fragen verwendet werden können. Eine schönes Feature von CSS3 ist die transform: rotate Anweisung, mit der bei Multi-Choice-Fragen die möglichst kurzen Antworttext schräg angezeigt werden können und so vielleicht einige Antwortmöglichkeiten mehr dargestellt werden können. Nichtsdestotrotz müssen hier die AutorInnen die Darstellung der Frage im Player überprüfen.


Da diese Fragen häufig für Umfrage-artige Abschnitte innerhalb eines Falles verwendet (bzw. eigentlich missbraucht) werden, diese Nutzung aber irgendwie auch berechtigt ist, muss im nächsten Schritt ebenso nachimplementiert werden, dass nicht-auswertbare Fragen wie Evaluationsfragen behandelt werden, d.h. nicht ausgewertet, erklärt und im Endergebnis miteinberechnet werden.

Design des Zeitfortschrittsbalkens

Ein möglichst originalgetreuer Nachbau des Zeitfortschrittsbalkens wäre ungefähr so gewesen:

Da aber in der Ergebnisanzeige auch um die Farben hellrot und hellgrün eingesetzt werden, wurde eine dieser Ergebnisanzeige möglichst ähnliche Darstellung gewählt:

Hier fehlt aber die klar erkennbare Grenze zwischen "gesetzte maximale Bearbeitungsdauer" und Überziehungszeit.

Das sind nun zuviele Informationen: 2 Striche und dann noch verschiedene Farben, vielleicht doch wieder der einfacher grün/rot-Verlauf:

Die Farbe zwischen grün oder rot ist aber leider nicht schön. Vielleicht wäre es besser, wenn man das einfach in drei Zonen aufteilt: Grün, hellgrün, hellrot - dunkelrot wird der sich wachsende Zeitbalken bei Erreichen von 100% sowieso:

Das ist leider zu hässlich, also vielleicht einfach den mittleren Strich weglassen?

Und dann vielleicht noch einen ein bisschen weicheren Übergang zwischen hellgrün und hellrot?

Eigentlich gar nicht schlecht so.


Aber eigentlich soll der Fortschrittsbalken dazu da sein, die Prüfungssituation nachzustellen - und in einer Prüfung schaut es so aus:

bzw. für Datenfreaks:

Oben der Zeitfortschritt, unten der Bearbeitungsfortschritt.


Es wäre also doch zweckdienlich, den Zeitfortschrittsbalken möglichst ähnlich zu gestalten - und da die Zeitanzeige bei zeitkritischen Fragen sowieso schon fast so wie die Zeitanzeige in Prüfungen aussieht, wird diese Anzeige der Bearbeitungsdauer nun einfach auch so gestaltet.


Während die Zeit "im grünen Bereich" abläuft, schaut es dann so aus:

Und bei Überschreiten der vorgesehenen maximalen Bearbeitungsdauer so:


Man könnte im nächsten Schritt zusätzlich auch den Bearbeitungsfortschritt wie in einer Prüfung anzeigen - vielleicht sollte das aber auch nicht passieren, denn der ist auch unten links im Ergebnisbereich irgendwie mit enthalten. Da bei den meisten Trainingsprüfungen die Fragen sowieso sofort ausgewertet werden und eine Erklärung dazu angegeben ist, würde man dann oben den Bearbeitungsfortschritt sehen und unten links das Ergebnis - das wären vielleicht zu viel eigentlich gar nicht benötigte Informationen. Der letzte sehr einfache Entwurf sollte ausreichen, um den gewünschten Zweck zu erzielen - nämlich einen leichten Zeitdruck zu erzeugen.

Notizblock-Funktion

Vor kurzem wurde das Markierungs-Feature vorgestellt, mit dem man Markierungen in den Informationen zu Fragen vornehmen kann. Dabei gibt es aber die Einschränkung, dass solche Markierungen nur angezeigt werden können, solange die entsprechenden Fragen auch angezeigt werden.


Da es aber manchmal auch hilfreich sein kann, sich Notizen machen zu können, auf die man dann jederzeit zugreifen kann, wurde zusätzlich mit der gleichen Technik wie bei der Markierungsfunkton ein Notizblock zur Verfügung gestellt: